Modelos de IA abiertos y locales: cómo probarlos bien
Un modelo abierto es gratis como un auto regalado. Los tres niveles de modelos, lo que cuestan de verdad y por qué conviene probar en OpenRouter antes de comprar un servidor.
Un modelo abierto es gratis como es gratis un auto regalado. Hasta que pagás la nafta, el seguro, la cochera y el mecánico.
En 2026 los modelos abiertos dejaron de ser un juguete de programadores: en algunas de las plataformas más grandes ya procesan la mitad del trabajo. Y muchas empresas sacan la conclusión equivocada: "compremos un servidor y corramos la IA en casa".
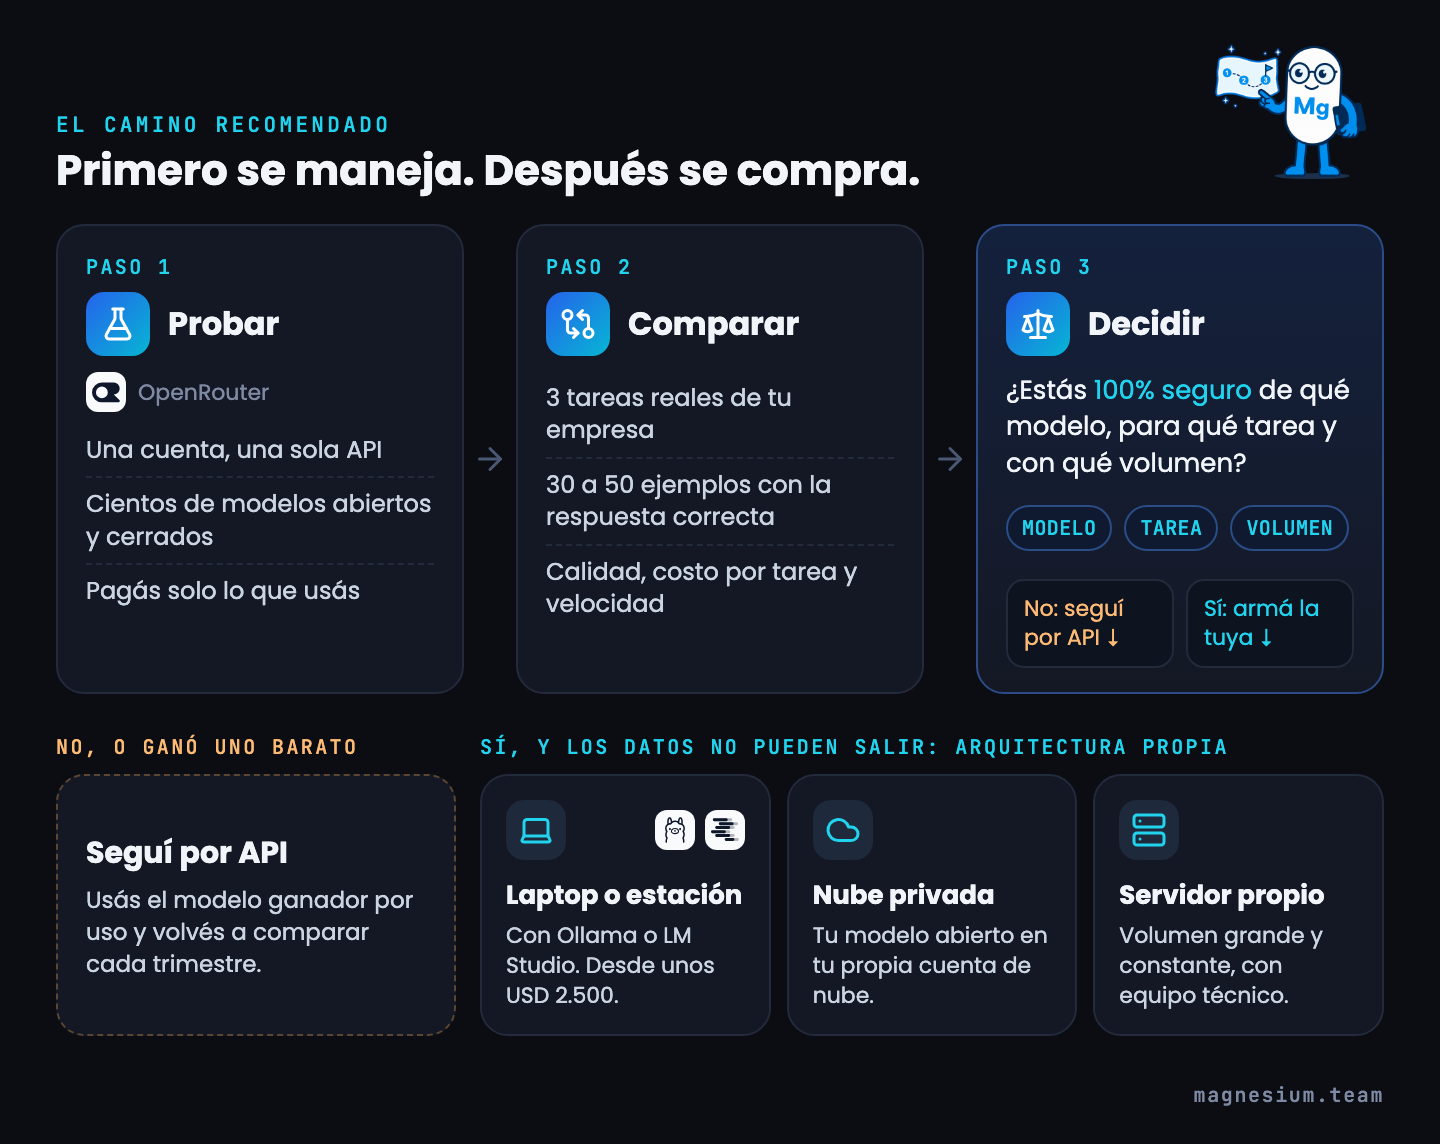
El orden correcto es el inverso. Primero se maneja. Después se compra.
Abierto, local y cerrado: tres cosas distintas
Antes de hablar de precios, tres palabras que se usan como sinónimos y no lo son.
- Cerrado. El modelo solo se usa a través de su fabricante: Claude, ChatGPT, Gemini. No ves cómo está hecho. Pagás por uso o por licencia.
- Abierto. El fabricante publica el modelo para que cualquiera lo descargue: Gemma de Google, Muse Glimmer de Meta, Qwen, DeepSeek, Mistral. Lo podés correr vos, o pagarle a un tercero que lo corre y te lo vende por uso, a centavos.
- Local. Un modelo abierto corriendo en un equipo tuyo: una laptop, un servidor, tu propia nube. Los datos no salen de la empresa.
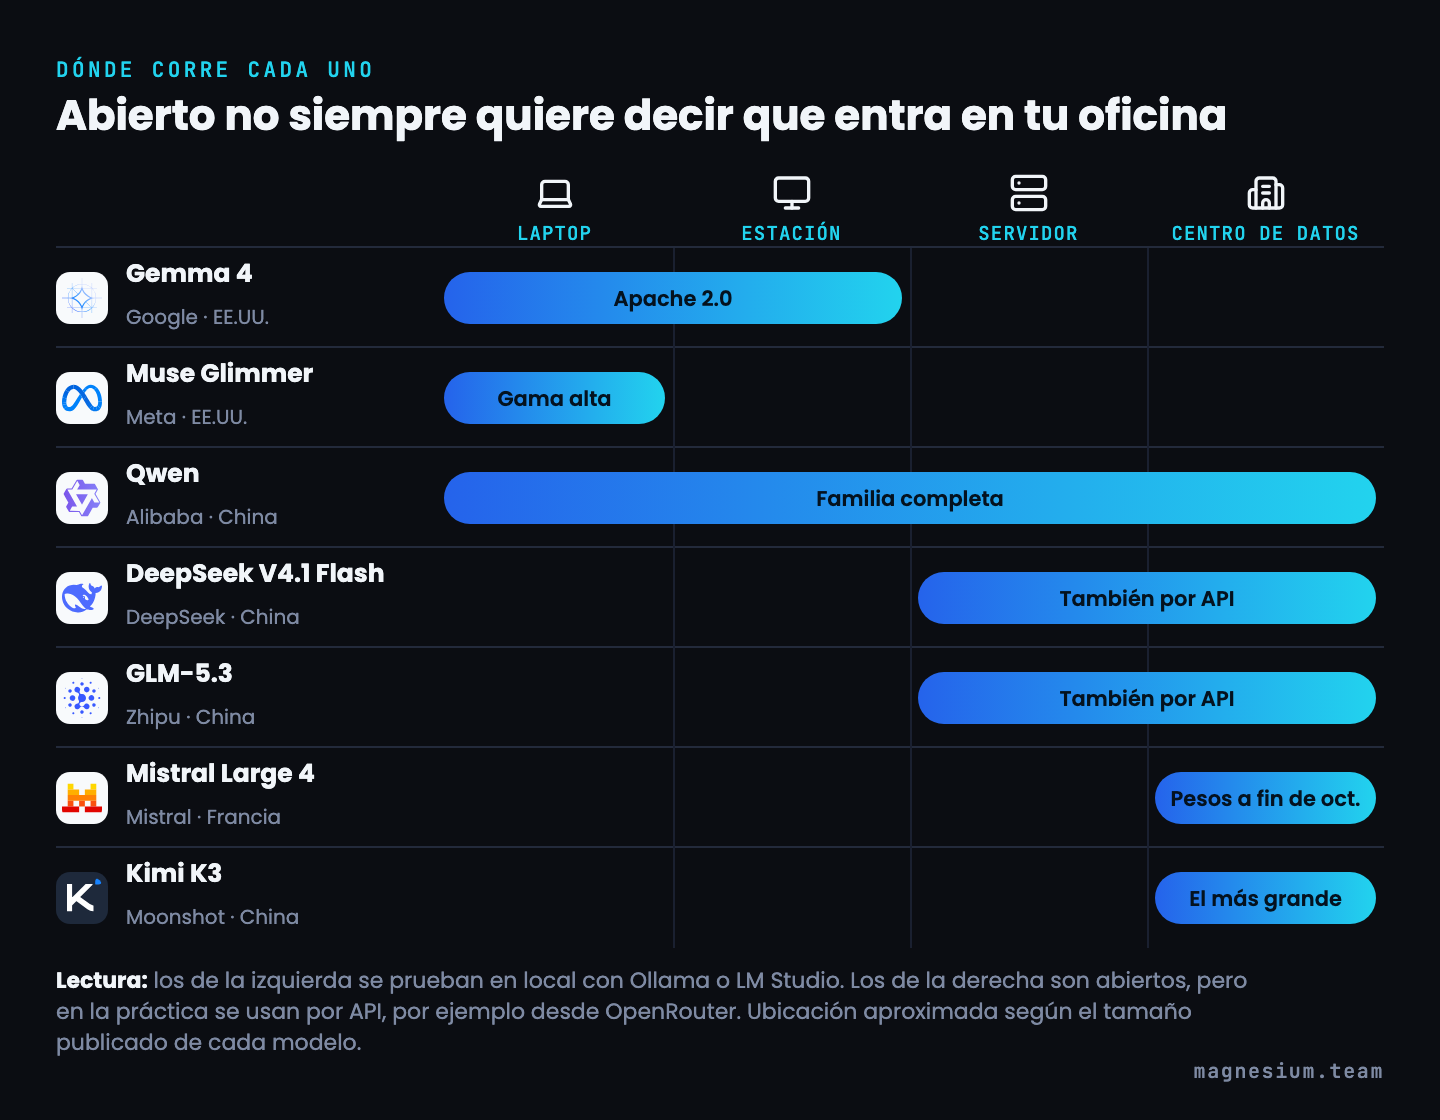
Todo modelo local es abierto. No todo modelo abierto es local. Kimi K3, de la china Moonshot, es abierto y tiene 2,8 billones de parámetros: para correrlo hace falta un centro de datos, no una oficina.
Abierto describe la licencia. Local describe la dirección.
Los tres niveles de modelos, y para qué sirve cada uno
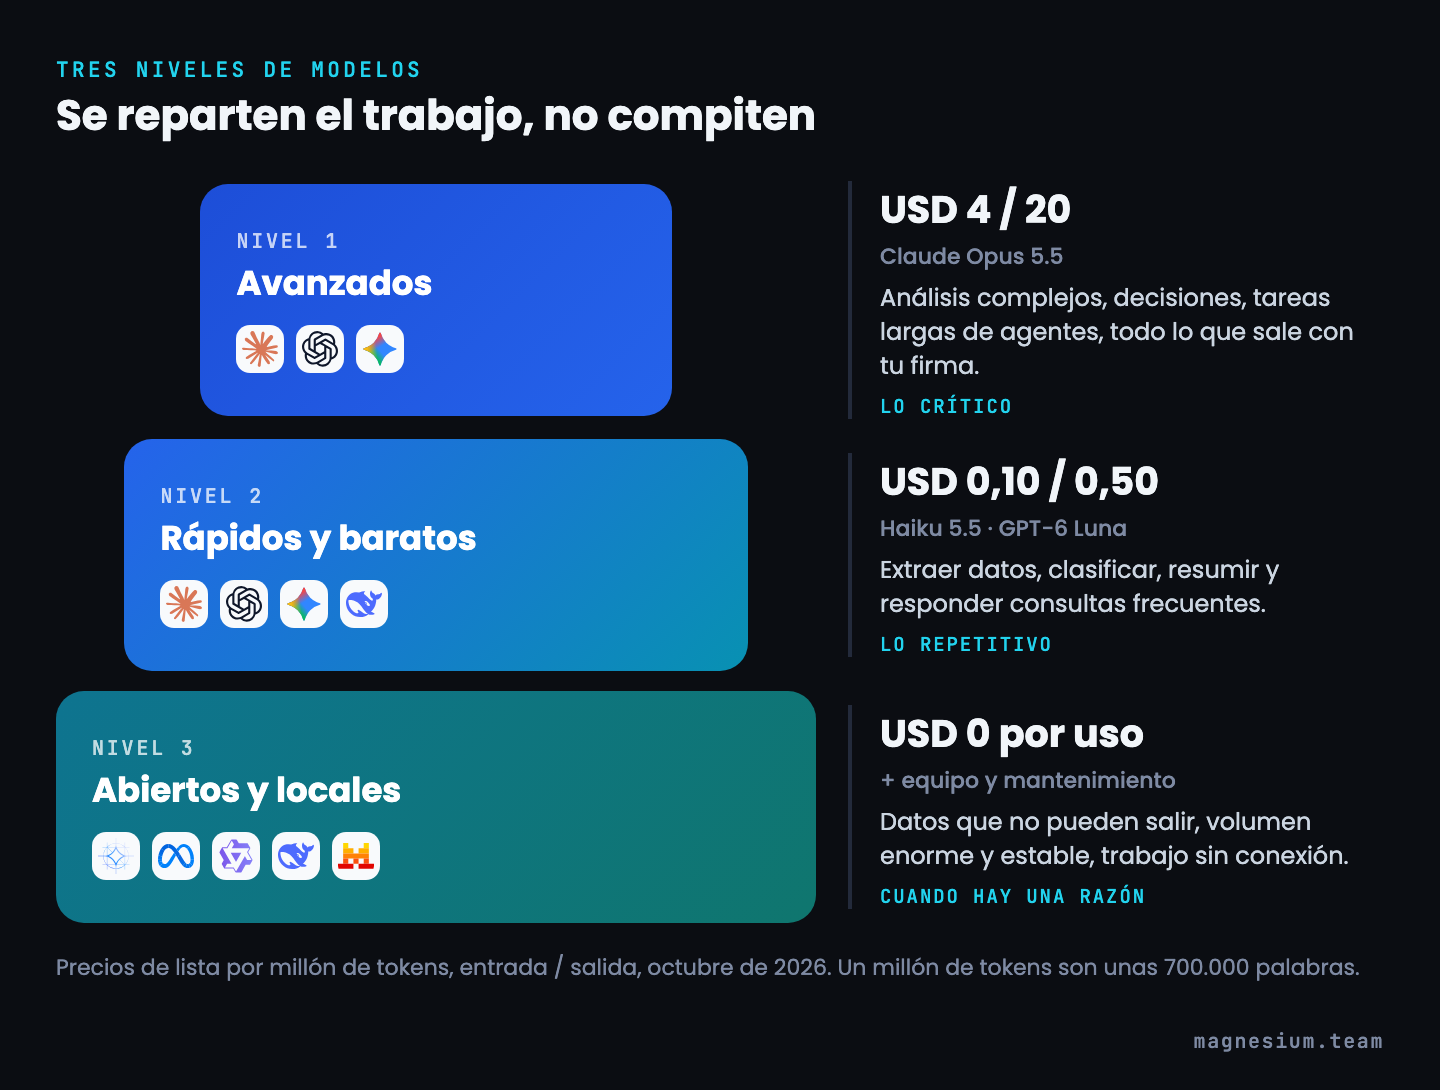
Hoy cualquier empresa elige entre tres niveles. No compiten entre sí: se reparten el trabajo.
Nivel 1: avanzados. Claude Opus 5.5 y los modelos de punta de OpenAI y Google. Para análisis complejos, decisiones con muchas variables, tareas largas de agentes y todo lo que sale con tu firma. Opus 5.5 cuesta USD 4 por millón de tokens de entrada y USD 20 de salida. Un millón de tokens son unas 700.000 palabras.
Nivel 2: rápidos y baratos. Claude Haiku 5.5 y GPT-6 Luna, a USD 0,10 de entrada y USD 0,50 de salida. Gemini 3.8 Flash, a USD 0,75 y USD 3,75. DeepSeek V4.1 Flash, un modelo abierto que se usa por API, a USD 0,30 y USD 1,20 en hora pico y la mitad fuera de pico. Para volumen: extraer datos, clasificar, resumir, responder consultas frecuentes.
Nivel 3: abiertos y locales. Gemma 4, Muse Glimmer, Qwen y compañía, corriendo en tu equipo. Sin costo por uso, con costo de equipo y de mantenimiento. Para datos que no pueden salir, volumen enorme y estable, o trabajo sin conexión.
La regla práctica: lo repetitivo va al nivel 2, lo crítico al nivel 1, y el nivel 3 entra cuando hay una razón concreta. No una moda.
El mejor modelo no existe. Existe el mejor modelo para esta tarea.
Cuánto cuesta de verdad: leer 1.000 facturas
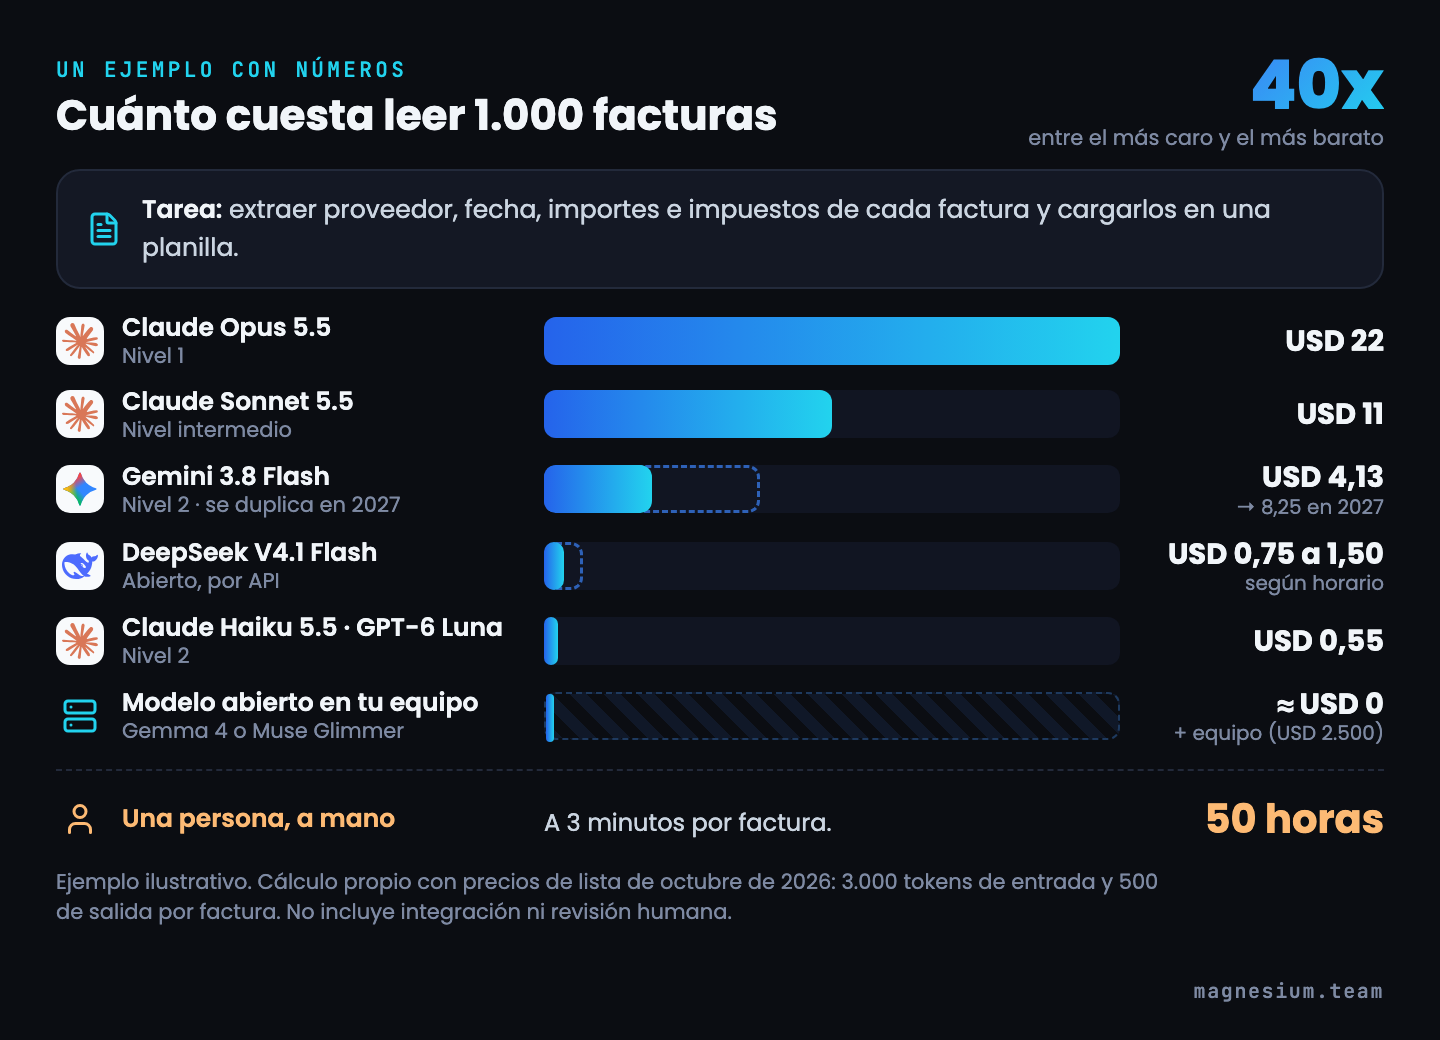
Un ejemplo ilustrativo, con precios de lista de octubre de 2026. La tarea: leer 1.000 facturas en PDF y cargar proveedor, fecha, importes e impuestos en una planilla. Calculamos unos 3.000 tokens de entrada y 500 de salida por factura.
- Claude Opus 5.5: USD 22.
- Claude Sonnet 5.5: USD 11.
- Gemini 3.8 Flash: USD 4,13, que pasan a USD 8,25 cuando el precio se duplique el 1 de enero de 2027.
- DeepSeek V4.1 Flash por API: entre USD 0,75 y USD 1,50, según el horario.
- Claude Haiku 5.5 o GPT-6 Luna: USD 0,55.
- Un modelo abierto en tu equipo: casi cero por factura, más el equipo, que arranca en unos USD 2.500.
- Una persona, a mano: 50 horas, a tres minutos por factura.
Entre el más caro y el más barato hay 40 veces de diferencia. Y los dos son ridículamente baratos frente a 50 horas de trabajo humano.
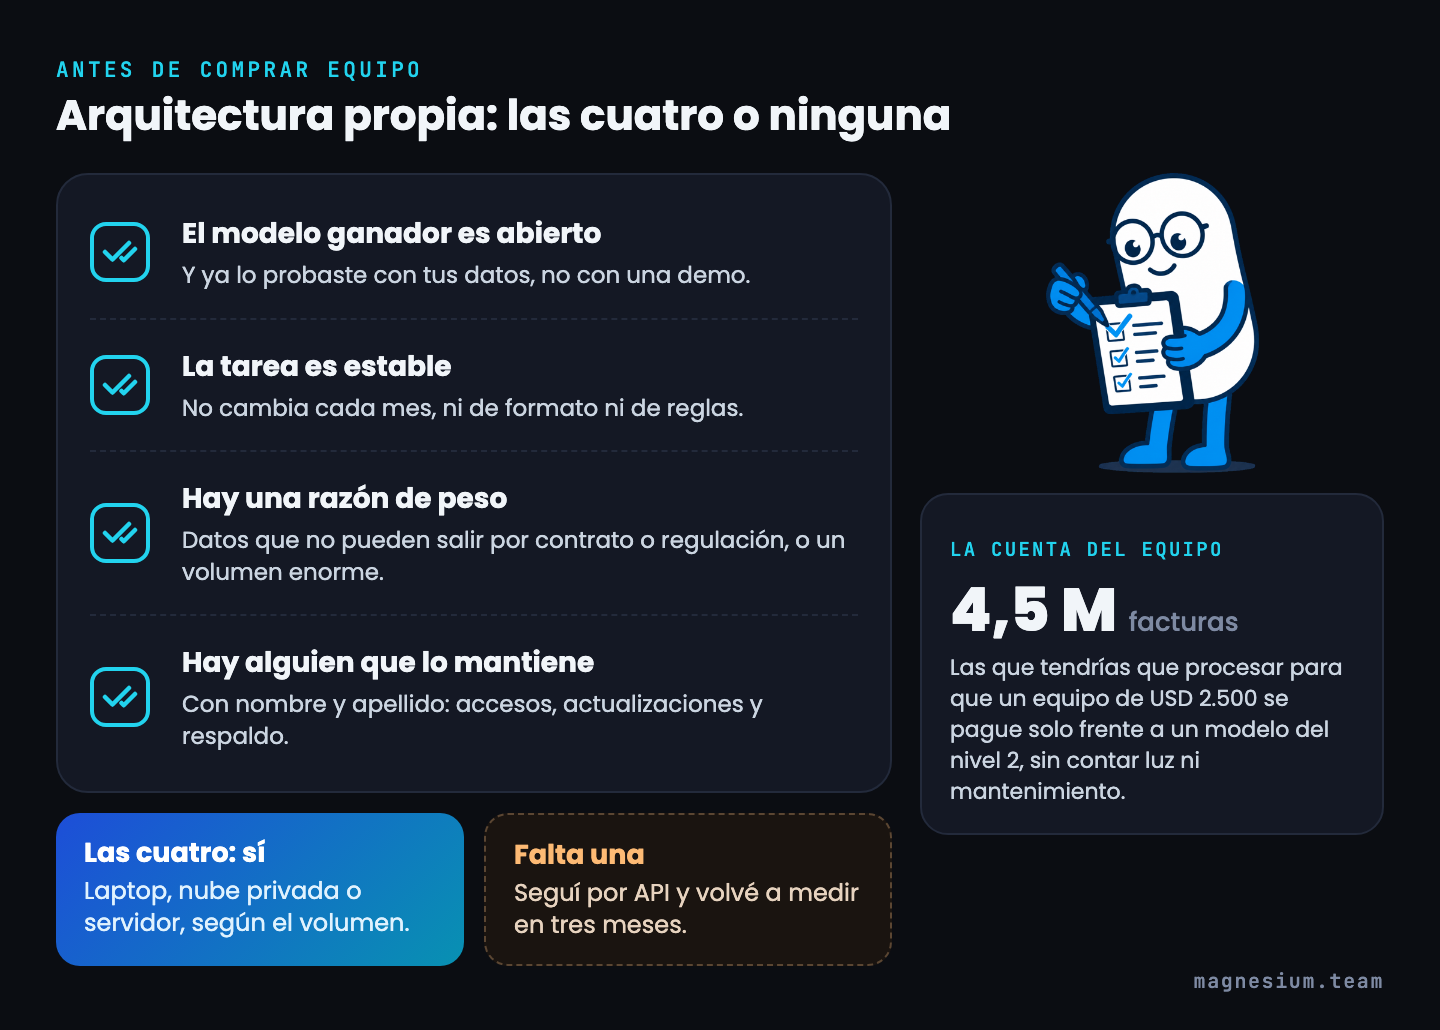
Ahora mirá la cuenta del servidor propio. Si el nivel 2 te cobra 55 centavos cada mil facturas, un equipo de USD 2.500 recién se paga después de unos 4,5 millones de facturas, sin contar luz ni mantenimiento. El servidor propio casi nunca se justifica por precio. Se justifica por otra cosa: datos que no pueden salir o un volumen gigantesco.
Y un detalle que se olvida: los precios de lanzamiento no son para siempre. Gemini 3.8 Flash ya avisó que se duplica en enero. Presupuestá con el precio que viene, no con el de la promoción.
Por qué los abiertos crecieron tanto en un año
Los números de 2026 son difíciles de ignorar.
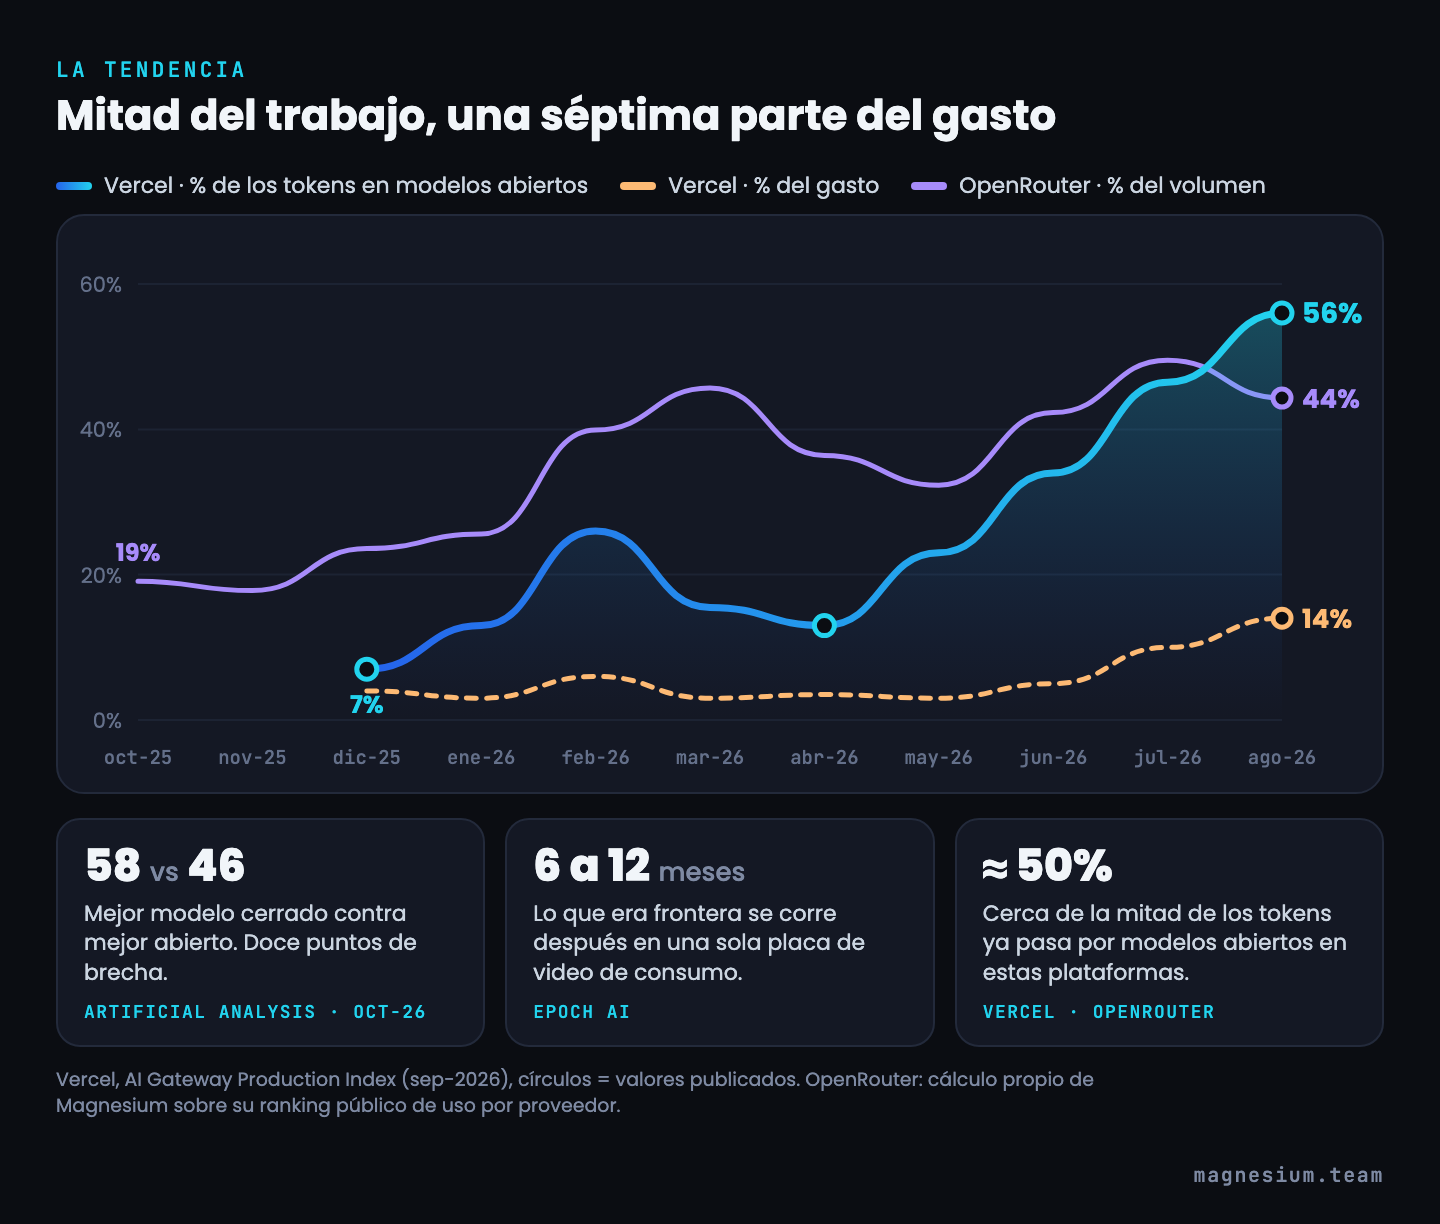
- Vercel, una de las mayores plataformas para construir aplicaciones con IA, informó que los modelos abiertos pasaron de procesar el 7% de los tokens en diciembre de 2025 al 56% en agosto de 2026. Pero fueron solo el 14% del gasto.
- OpenRouter, el mayor intermediario de modelos, muestra la misma curva: los abiertos pasaron del 19% al 44% del volumen entre octubre de 2025 y agosto de 2026. Es un cálculo nuestro sobre su ranking público de uso por proveedor.
- Epoch AI midió que con una sola placa de video para juegos, como una RTX 5090, se corren modelos que igualan lo que era la frontera de 6 a 12 meses antes.
- Artificial Analysis, que mide la inteligencia de los modelos con diez evaluaciones, ubica hoy al mejor cerrado en 58 puntos (Claude Opus 5.5) y al mejor abierto en 46 (MiMo-V2.6-Pro, de Xiaomi). Doce puntos de distancia.
Leelo junto: los abiertos hacen la mitad del trabajo y se llevan una séptima parte de la factura. La brecha de calidad existe, pero para leer facturas o clasificar correos no se nota.
Los abiertos no ganaron por ser mejores. Ganaron por ser suficientes, y baratos.
Los modelos abiertos que conviene conocer
No hace falta seguirlos a todos. Con esta lista alcanza para no perderse.
- Gemma 4 (Google). Salió en abril de 2026 con licencia Apache 2.0, una de las más permisivas. Viene en tamaños que van del celular al servidor. Es el punto de partida más fácil para probar en local.
- Muse Glimmer (Meta). Agosto de 2026, el primer modelo abierto de Meta después de la era Llama. Corre en una laptop de gama alta.
- Qwen (Alibaba). Una familia amplia, de modelos chicos a enormes, con mucho uso en OpenRouter. Alibaba anunció Qwen 4 sin fecha.
- DeepSeek V4.1 Flash. Septiembre de 2026, licencia MIT, contexto de un millón de tokens. Barato por API y descargable.
- Kimi K3 (Moonshot). Julio de 2026. El modelo abierto más grande publicado hasta ahora. Abierto, sí. Para tu oficina, no.
- GLM-5.3 (Zhipu). Entre los abiertos más altos del índice de Artificial Analysis, con 45 puntos en su versión más potente.
- Mistral Large 4 (Mistral). La opción europea. Ya se usa por API en vista previa y la empresa anunció los pesos para fin de octubre; la prensa especializada habla del 27.
Fijate en un detalle: casi todos los abiertos más potentes son chinos. Eso no es un dato técnico. Es una decisión de negocio, y vuelve más abajo.
Elegir un modelo abierto es elegir también quién lo hizo y quién lo va a mantener.
Empezá por OpenRouter: el test drive
Nadie compra un auto por el folleto. Lo maneja por su ruta, con su familia adentro, en su horario de tránsito. Con los modelos pasa lo mismo, y OpenRouter es la concesionaria con todos los autos en la puerta.
Cómo funciona:
- Una cuenta y una sola API para cientos de modelos abiertos y cerrados: Claude, GPT, Gemini, DeepSeek, Qwen, Mistral y casi todos los de esta nota.
- Pagás por uso. Cargás crédito y cada consulta descuenta lo que cuesta. OpenRouter cobra el mismo precio que el proveedor, sin recargo en el uso del modelo. Su comisión está al cargar crédito: 5,5% con tarjeta, con un mínimo de USD 0,80.
- Enrutamiento. Un mismo modelo abierto lo ofrecen varios proveedores. Si uno falla, OpenRouter pasa solo al siguiente, y le podés pedir que priorice el más barato o el más rápido.
- Control de datos. En la configuración podés excluir a los proveedores que entrenan con lo que les mandás, y filtrar por política de retención.
El método, en cinco pasos:
- Elegí tres tareas reales. No demos. Las que hoy le comen horas a alguien.
- Juntá entre 30 y 50 ejemplos de cada una, con la respuesta correcta al lado. Anonimizados si tienen datos sensibles.
- Corré los mismos ejemplos en cuatro o cinco modelos, al menos uno de cada nivel.
- Puntuá en una planilla calidad, costo por tarea y velocidad.
- Quedate con el más barato que pasa la vara. No con el que ganó el ranking.
Dos semanas de test drive te ahorran un año de arquitectura equivocada. No es la única opción del mercado (Vercel tiene su propio gateway, por ejemplo), pero es la forma más directa de comparar.
La única prueba que vale es la tuya: tus datos, tus tareas, tu vara.
Cuándo armar tu propia arquitectura
Recién cuando estás 100% seguro de qué modelo, para qué tarea y con qué volumen. Antes, no.
Cuatro condiciones, y tienen que cumplirse las cuatro:
- El modelo ganador es abierto y ya lo probaste con tus datos.
- La tarea es estable: no cambia cada mes.
- Hay una razón de peso: datos que no pueden salir por contrato o por regulación, o un volumen tan alto que la API sale más cara que el equipo.
- Hay alguien que lo mantiene, con nombre y apellido.
Si las cuatro dan sí, hay tres caminos:
Laptop o estación de trabajo. Con Ollama o LM Studio, dos aplicaciones que bajan y corren modelos abiertos con un par de clics. Para una persona o un equipo chico que trabaja con documentos sensibles. Desde unos USD 2.500 de equipo.
Nube privada. El modelo abierto corriendo en tu propia cuenta de AWS, Google Cloud o Azure. Los datos quedan dentro de tu perímetro y no comprás hierro. Pagás por las horas de máquina.
Servidor propio. Para volumen grande y constante, con equipo técnico que lo opere. Es el que más ahorra a escala y el que más cuesta equivocarse.
La arquitectura propia es el final del camino, no el principio.
Los riesgos que no aparecen en la demo
El auto propio no tiene concesionaria que te lo arregle. Cuatro cosas para mirar antes de firmar.
Seguridad. Por API, el proveedor cuida el perímetro. En local, lo cuidás vos: quién accede, qué consulta queda registrada, quién instala las actualizaciones.
Mantenimiento. Los modelos envejecen en meses. Si lo que hoy es frontera llega a una placa de consumo en menos de un año, el modelo que instales hoy va a quedar atrás en un año. Actualizarlo es un proyecto, no un clic.
Licencias. Apache y MIT son muy permisivas. Otras traen condiciones de uso propias. Alguien las tiene que leer antes de poner un modelo en producción.
Origen. En 2025 Australia, Corea del Sur, Taiwán, India y organismos de Estados Unidos como la NASA y la Cámara de Representantes restringieron DeepSeek en equipos oficiales, e Italia bloqueó su aplicación. Correr un modelo chino en tu servidor no manda datos a China. Pero si le vendés al Estado o a un sector regulado, tu cliente puede tener la regla igual. Preguntá antes de elegir.
Cuando la IA corre en tu casa, el riesgo también vive en tu casa.
Por dónde empezar esta semana
No compres nada. Abrí una cuenta en OpenRouter, cargá USD 20 y elegí una tarea que hoy le come horas a alguien.
Corré 30 ejemplos en un modelo de cada nivel y anotá tres columnas: calidad, costo y velocidad. En una tarde vas a saber más que en un mes de leer comparativas.
Si el ganador es un modelo de centavos, ya está: lo usás por API y seguís. Si es un modelo abierto y tus datos no pueden salir, recién ahí hablamos de equipo propio.
¿Querés que calculemos el costo por proceso de tu empresa con modelos reales y te digamos qué conviene correr afuera y qué en casa? Hablemos.
Fuentes
- OpenRouter FAQ — OpenRouter
- Provider logging and data policies — OpenRouter
- Frontier AI performance becomes accessible on consumer hardware within a year — Epoch AI
- The plunging price of thought — Epoch AI
- Open weights models: Intelligence Index — Artificial Analysis
- Open-weight AI models take majority of Vercel traffic — IT Brief UK
- Introducing Claude Haiku 5.5 — Anthropic
- Which countries have banned DeepSeek and why? — Al Jazeera